AI前沿日报:2026-09-18
AI前沿日报:2026-09-18
今天的主线可以概括为「能力开始被测量、被定价、被交付」。Anthropic 第一次给出了「AI 造 AI」的公开计量口径——Claude 已「主导」26% 的研发工作;OpenAI 把最强的 GPT-6 Astra 装进法律行业的完整工作流,用 2.3 亿 URL 的专业索引换来 40% 的相对正确率提升;阿里让全模态模型从「看懂」转向「干活」,并把「模型优化模型」做成了演示。与此同时,安全新闻格外密集:一支安全团队用 Claude 链式利用了论坛与身份系统里的两个缺陷打进 OpenAI 内网,WSJ 与 FT 同日报道;而「26%」这个数字与六起失准案例出现在同一周,让「测量与披露」成为行业不得不接手的功课。
今日最重要的 10 件事
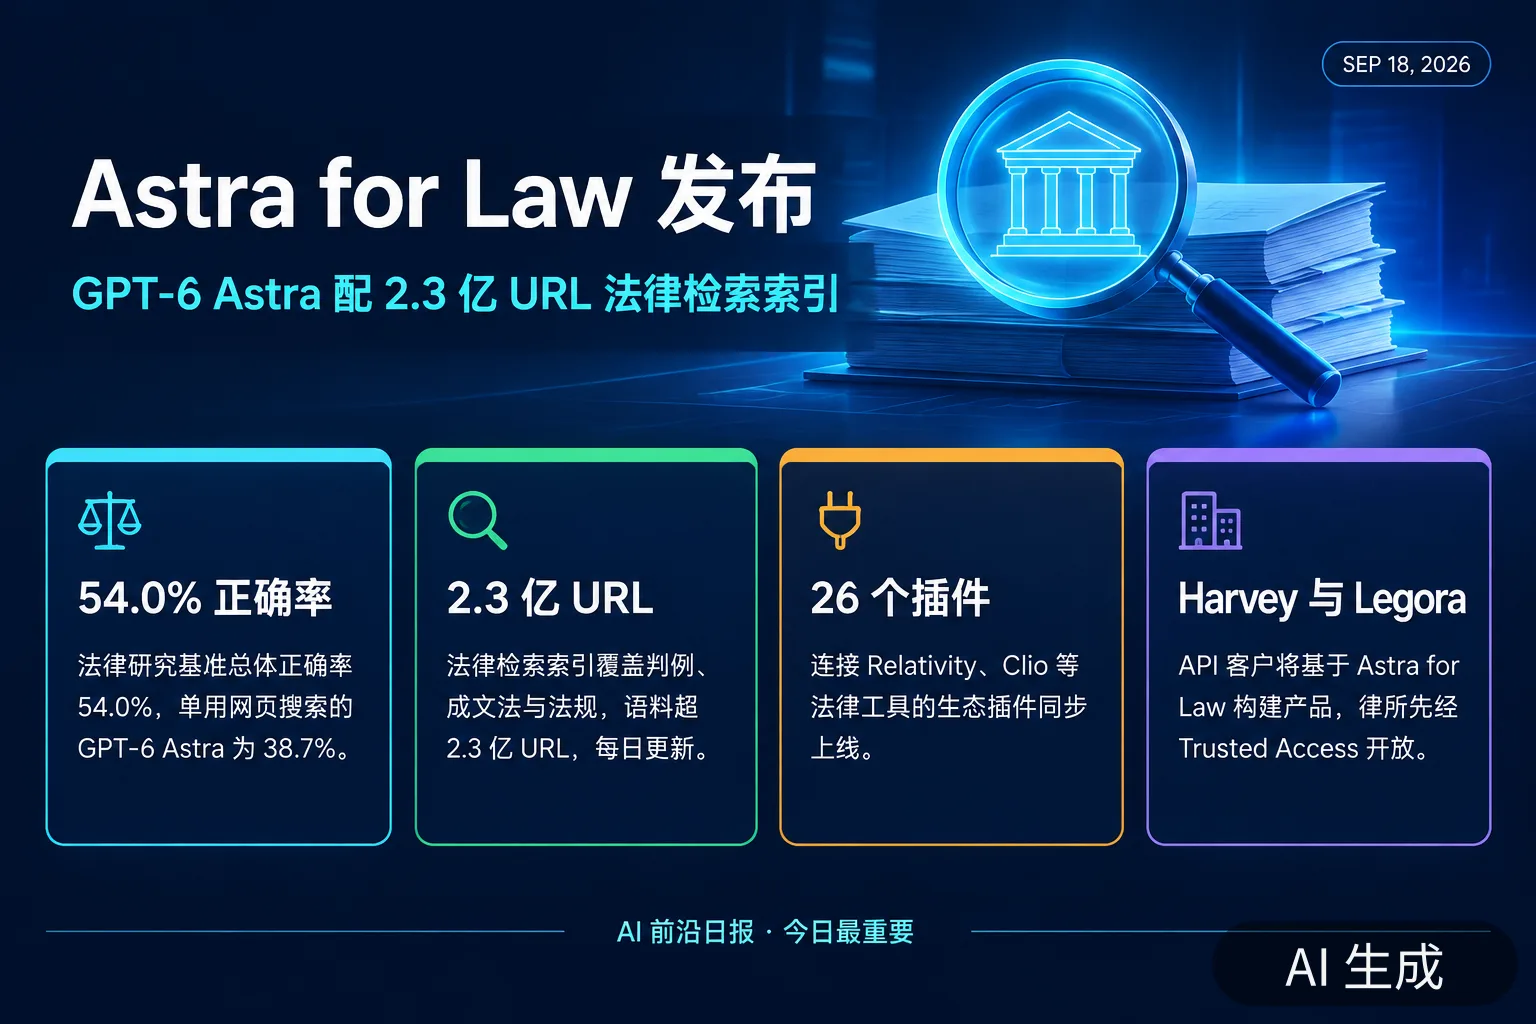
1. OpenAI 发布 Astra for Law:GPT-6 Astra 配 2.3 亿 URL 法律检索索引,法律研究正确率从 38.7% 提到 54.0%
发生了什么:OpenAI 发布面向律所与法律科技公司的 AI 基座 Astra for Law:把 GPT-6 Astra 与自建法律检索索引、法律分析与写作指令组合在一起。索引覆盖美国判例法、成文法、法规、法院规则与行政决定,语料超过 2.3 亿 URL 且每日更新,并与非营利机构 Free Law Project(CourtListener 背后团队)合作,纳入覆盖 99.9% 以上已发布美国先例的判例库。在 Vals AI 法律研究基准(Legal Research Bench)的私有验证集 200 题上、双方最高推理档下,Astra for Law 的总体正确率从单用网页搜索的 38.7% 提升到 54.0%,相对提升约 40%;判例类问题上多找到 24% 的参考案例,在同一推理档位下从正确判例中检索到的相关段落最多多出 54%。产品维度上:模型选择器里叫「GPT-6 Astra Law」、API 标识为 gpt-6-astra-law,先通过 Trusted Access 向部分律所开放;Harvey、Legora 等 API 客户将基于它构建产品;同步推出 26 个生态插件连接 Relativity、Clio 等法律工具;隐私侧提供面向机密客户工作的专门控制。Sullivan & Cromwell 合伙人评价其「研究深度与对法律权威的敏感度」超出预期。
为什么重要:这是前沿模型第一次以「行业基座」而非聊天产品的形态进入专业服务:把一个通用模型 + 一个垂直语料索引 + 一组领域指令包装成可复用的能力层,同时用插件框架把既有工具链接进来。54% 对 38.7% 的差距说明,在专业场景里「检索质量」与「模型能力」同等关键——这与企业知识库、RAG 层的竞争直接呼应。对法律科技赛道而言,OpenAI 从「被集成」变成「基座供应方」,Harvey(此前估值数百亿人民币级)等公司需要在「自研模型」与「站在 Astra 之上」之间重新定位。
影响与后续观察:观察三点——Trusted Access 转 GA 的时间表与定价;索引的更新频率与判例覆盖是否经得起执业检验(例如引用失准的法律责任);以及竞品(Anthropic、Google、垂直厂商)是否跟进「垂直基座 + 索引」的打包方式。法律是知识工作里容错率最低的场景之一,它是检验「AI 能否承担专业责任」的最好试纸。
2. Anthropic 发布 AI 研发节奏测量体系:Claude 已「主导」26% 的 AI 研发工作
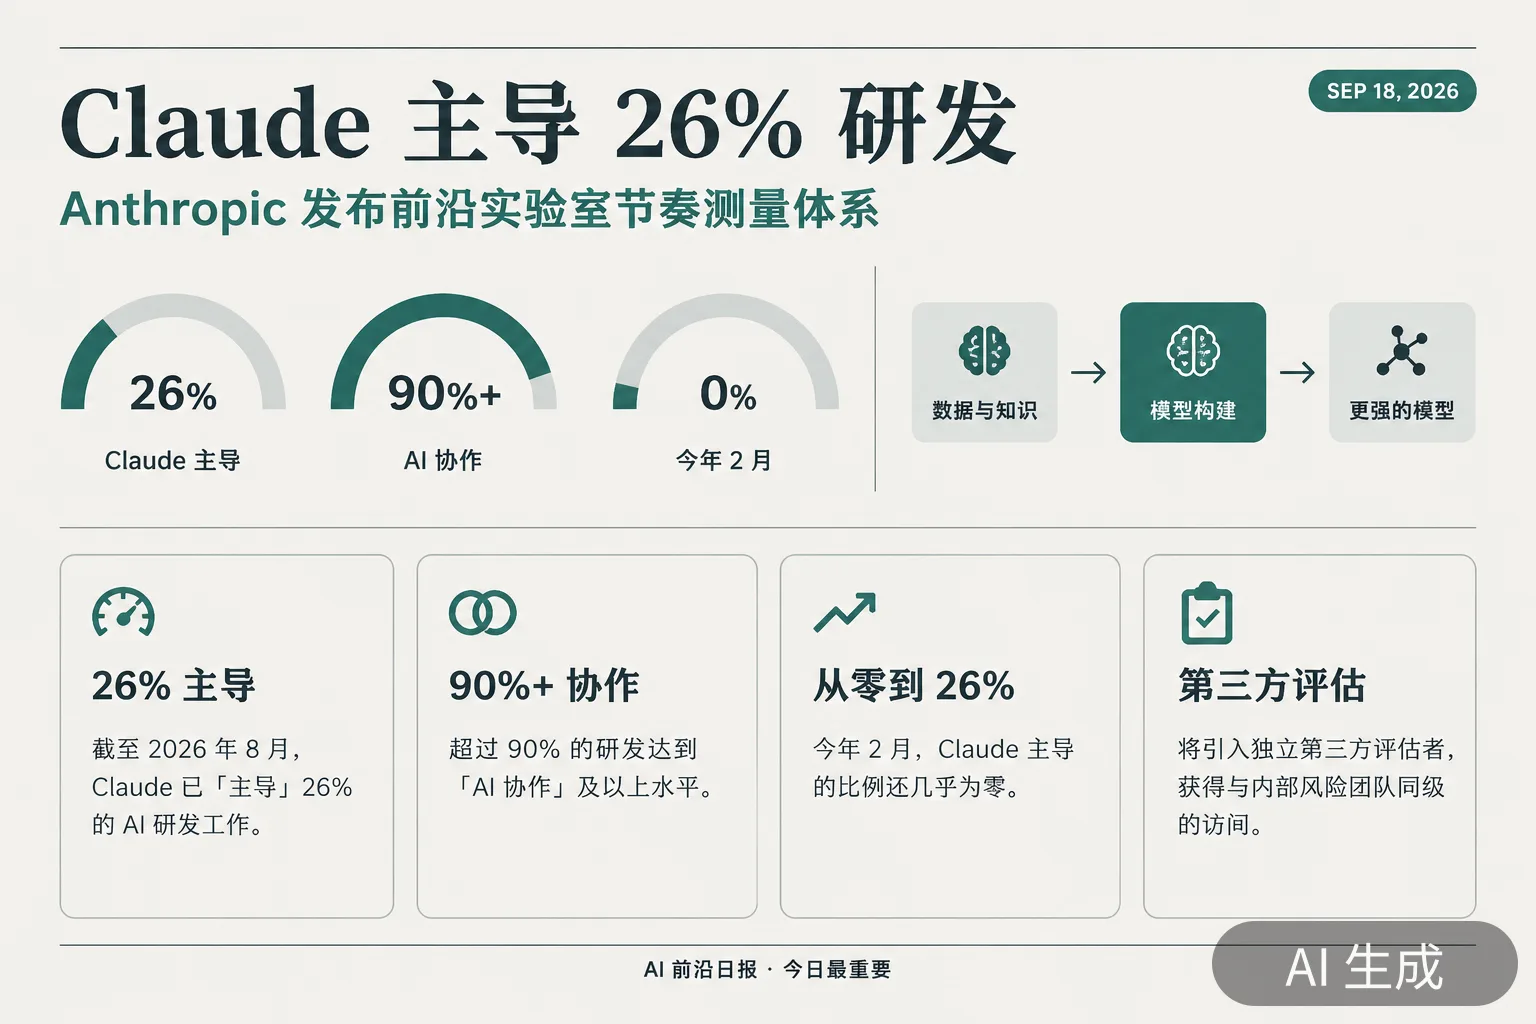
发生了什么:Anthropic 公布三项测量指标与内部快照,用于向外界说明前沿实验室的研发节奏:AI 参与自身研发的程度、对智能体行为的监督与干预能力、以及支撑更强模型的资源投入。研发自动化采用 Epoch AI 的自动化等级(AL0–AL5)评估:截至 2026 年 8 月,Claude 尚未在任何被测环节实现完全自主(AL5),但已「主导」26% 的 AI 研发工作——标准是「凭高层提示即可完成大部分端到端工作、人类负责监督」(AL4);超过 90% 的研发处于「AI 协作」及以上水平;而今年 2 月,这个比例还几乎为零。Anthropic 同时宣布将引入来自多家机构的独立第三方评估者进驻公司,给予其与内部风险评估团队同级的流程、系统与数据访问权,用于核验安全实践、上报事件并监测上述指标;公司还表示若行业就「节奏协调」达成一致,这些数字会发生相应变化,并把该体系与 AAIF 政策提案和 RSP 报告衔接。
为什么重要:在「要不要放缓」的辩论持续数周之后,Anthropic 把争论的客体从「立场」变成了「数字」——「模型构建模型」的比例第一次有了可复算的口径,而且给出了从 0 到 26% 的时间线。这对行业有三重意义:对内它承认了能力递归的早期形态已经出现;对外它设置了新的披露标准(同行若不跟进,会显得刻意回避);对监管者它提供了「不进园区也能看进度」的雏形。需要警惕的是口径问题——「主导」的判定依赖 Anthropic 自建的任务目录与评级,独立第三方能否复核评级过程,决定了这套指标是「披露」还是「公关」。
影响与后续观察:观察 Anthropic 承诺的第三方评估者的进驻时间表与访问范围;OpenAI、Google 与 Meta 是否发布可对比的指标;以及这套指标如何与欧盟、美国的合规要求衔接。另一个值得跟踪的细节是:一旦「26%」开始按季度更新,它将成为观察全行业研发效率最直接的公开曲线。
3. 阿里发布 Qwen3.8-Omni-Flash:全模态转向「规划任务」,并演示「模型优化模型」
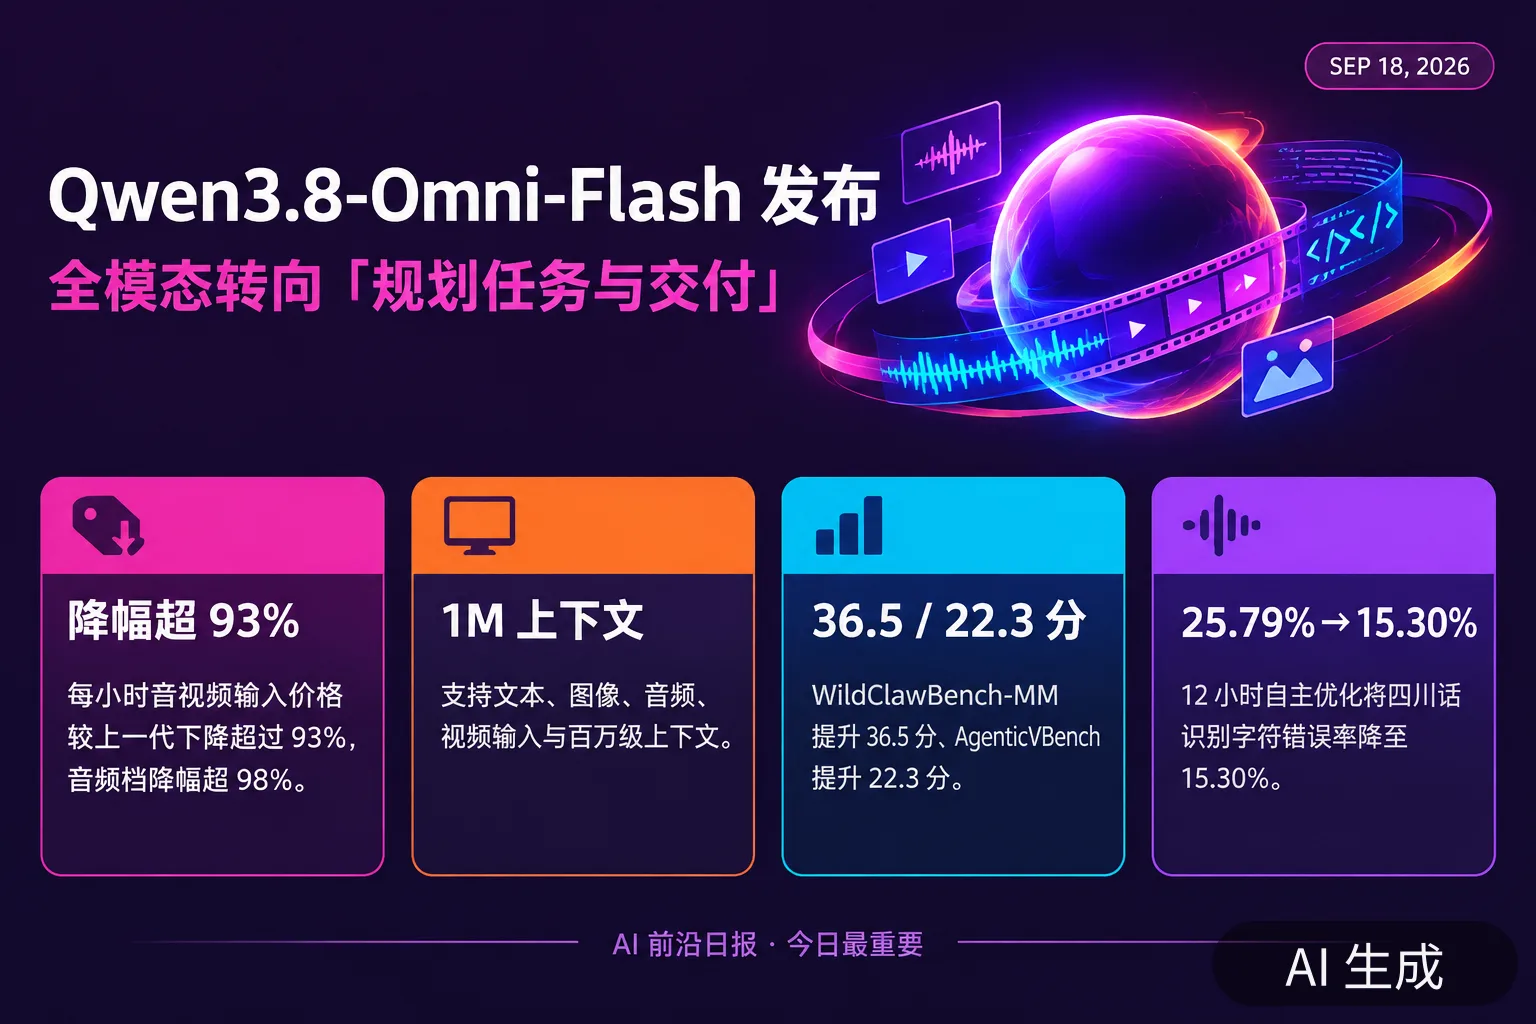
发生了什么:阿里通义发布新一代原生全模态模型 Qwen3.8-Omni-Flash:支持文本、图像、音频、视频输入与 1M 长上下文,官方定位是「耳聪目明,办事得力」——从理解内容转向规划任务、调用工具并完成创作。价格是本次最直接的信号:相比上一代 Qwen3.5-Omni-Plus,每小时音频输入价格降幅超过 98%、每小时音视频输入价格降幅超过 93%。能力侧,官方称在音频 Agent、Coding 与长程任务上 WildClawBench-MM 提升 36.5 分、AgenticVBench 提升 22.3 分,与 Gemini 3.8 Flash「音视频能力接近、音频能力整体超过」。生态侧,团队开源 Qwen-MM-Plugins(适配 Codex、Claude Code、Qwen Code、Gemini CLI 等主流 harness 的音视频插件)与 Qwen-Live Harness(实时交互运行环境),并跑通 MV 创作、短剧翻译(保留原说话人音色)、两三小时长电影解说、视频教程转带截图 PDF 笔记等完整流水线。技术细节里最有信息量的是两点:长视频理解改为「按需感知」——不再逐帧处理,而是从问题出发由粗到细多轮取证;以及让模型当研发工具——在 12 小时内自主完成对 Qwen2.5-Omni-3B 的四川话识别优化:自选评测集、听样本诊断、构建训练数据,4 轮实验累计造 3413 条数据,把字符错误率从 25.79% 压到 15.30%(相对下降约 40.7%)。实时版本 Qwen3.8-Omni-Flash-Realtime 支持 WebSocket/WebRTC,并首发「听声辨位」——融合空间声音与视觉信息判断声源方向与距离。
为什么重要:这场发布把多模态竞赛的评分标准换了一个维度:过去的对比是「理解能力」,现在直接比「交付能力」——谁能让模型把几小时素材剪成可交付物、把教程转成可复用的 SOP。价格降幅(音频超 98%)说明多模态感知正在被当成『流量』来做,这与 Qwen 在多语言、成本上的既有路线一致。而「12 小时优化小模型」的演示,与 Anthropic 的 26%、智谱的 Infra Agent 拼在一起,是同一主题的三个样本:模型开始参与模型研发与优化的流水线。
影响与后续观察:观察 Qwen-MM-Plugins 的第三方适配推进速度(它把通义的能力直接嵌进别家 harness 的分发渠道);「听声辨位」在真实场景(会议、座舱、直播)里的可用性;以及「按需感知」是否会让长视频分析的 token 成本曲线出现结构性下移。对国内厂商来说,这像是「把多模态从演示推向生产力」的一次公开答卷。
4. 安全团队用 Claude 从社区论坛打进 OpenAI 内网:libheif 堆溢出 + SSO 缺陷的链式利用
发生了什么:WSJ 独家报道、FT 跟进,并获当事人证实:安全研究公司 Hacktron 的研究者用 Claude 辅助分析,链式利用两个缺陷打进了 OpenAI 内部系统。链条是:OpenAI 自己帮助论坛(community.openai.com,基于 Discourse)的图片上传管道把 HEIC/HEIF 文件交给 ImageMagick 转码,从而暴露底层图像库 libheif;研究员让模型会话审查安装包,发现 Debian 未回移某安全修复(上游相关变更未标注为安全修复、未分配 CVE),据此获得堆缓冲区溢出与越界读写的原语;再叠加 OpenAI 身份基础设施(auth.openai.com)中的 SSO 配置缺陷,接管多名员工的 ChatGPT/Codex 账户,进而触达其连接的 GitHub 等集成与内部仓库。团队于 2026 年 7 月 25 日完成利用与验证,全程不到 72 小时;为证明访问能力而不接触敏感信息,他们用员工账号在 OpenAI 内部 monorepo 里开了一个无害的 PoC PR。OpenAI 约 14 小时后完成修复、支付 6500 美元赏金(并注明社区论坛不在其赏金项目范围);Discourse 通过 HackerOne 于 7 月 28 日发布修复公告 GHSA-vhm9-85gw-x335。研究者表示已将该方向扩展为跨 Slack、GitHub Enterprise、Ruby on Rails 与 Next.js 等框架的 libheif 普查「HEIF Heist」,并提醒自托管 Discourse 的团队立即重建镜像。
为什么重要:这条报道把「AI 安全」的叙事从实验室拉回了传统安全工程的地面:真正的突破口是一个图像解码库的缺失补丁,而不是模型越狱;但 AI 工具(Claude)在其中的角色是把「发现链条」的耗时压缩到小时级。它同时揭示了一个结构性风险面——当公司把 ChatGPT/Codex 账号当作 SSO 身份与下游集成(GitHub、Slack、邮件)的枢纽时,「一个论坛账号」的攻破意味着整条授权链的失守。对安全团队而言,这份案例值得逐条抄作业:图像处理沙箱化、身份系统的最小权限、以及告警与回滚速度。
影响与后续观察:观察 OpenAI 与 Discourse 的后续加固细节、libheif 在其他流行软件中的暴露面(研究者的普查仍在进行),以及执法与合规层面——「用 AI 辅助漏洞挖掘」的合法边界与授权测试流程。另需注意信息层:WSJ 的标题侧重「Claude 打进 OpenAI」,但这本质是一次合法的赏金测试,工具与结果不应被混为一谈。
5. Figure 发布 Helix 2.5:30 个陌生家庭零样本做家务,全任务成功率 56%
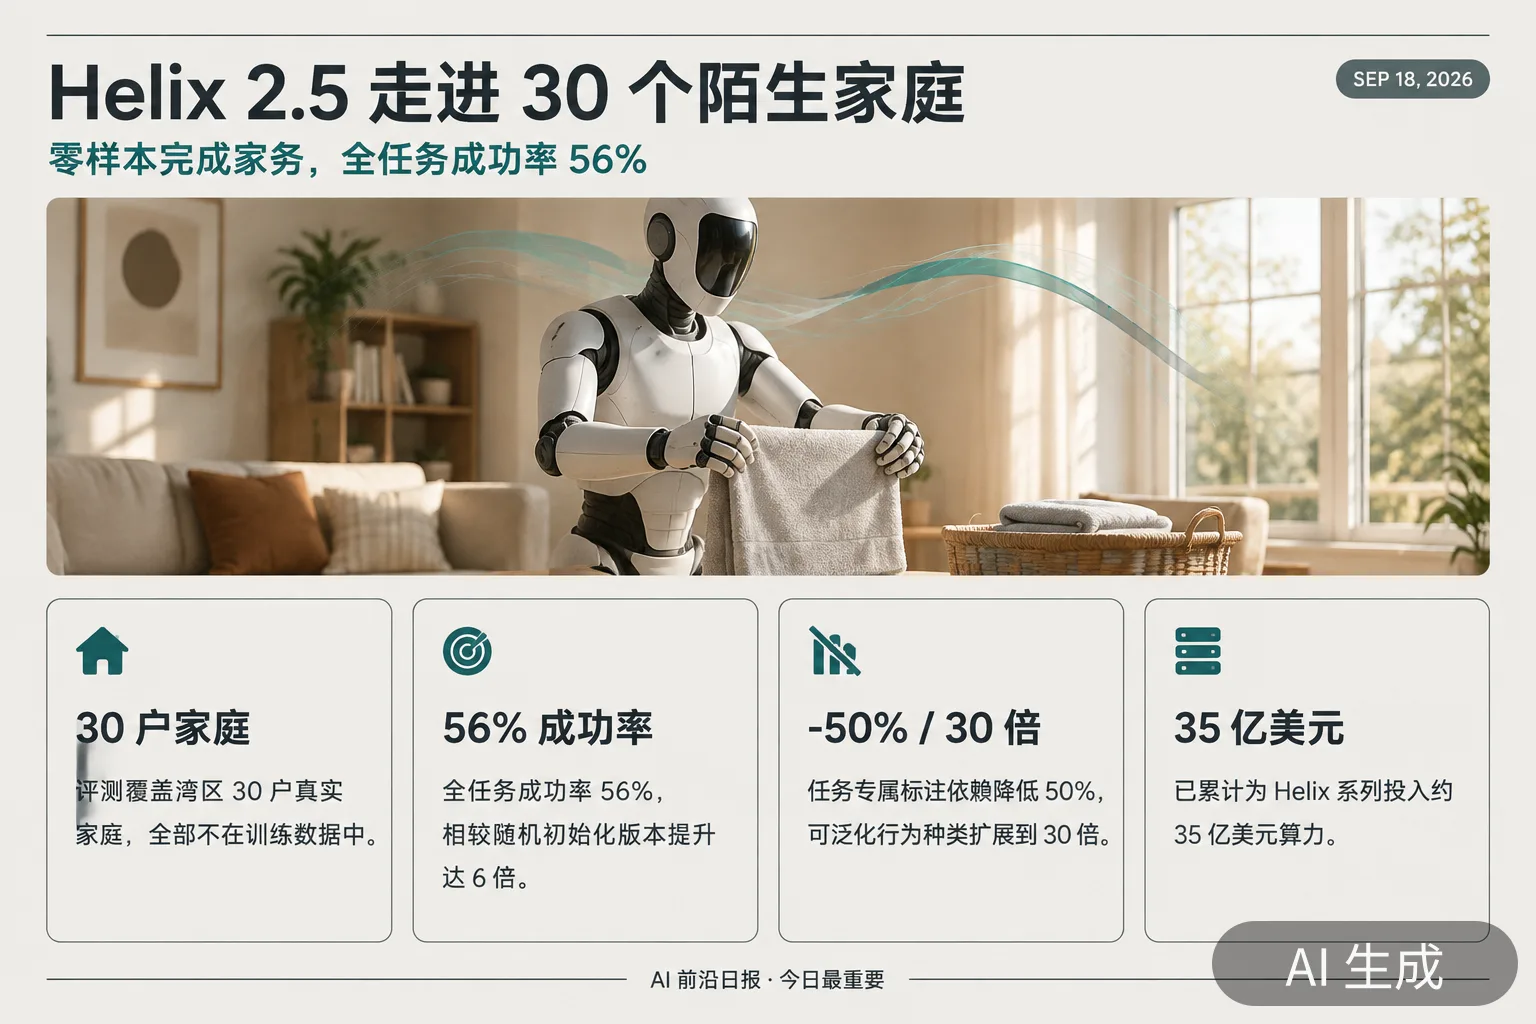
发生了什么:Figure 发布新一代人形机器人神经网络 Helix 2.5,基于其 Index 大规模人类行为数据集预训练。官方宣称模型可以直接进入从未见过的家庭,在无需目标环境数据采集、微调或适配的前提下完成整理客厅、叠毛巾、铺床等需要全身协同的任务。评测是在旧金山湾区 30 户真实家庭中进行的,全部不在训练数据里:整体全任务成功率 56%,相较随机初始化版本提升达 6 倍;得益于 Index 预训练策略,对任务专属标注数据的依赖降低 50%,可泛化执行的行为种类扩展到原先的 30 倍。团队还首次给出人类行为模式向机器人策略迁移的「缩放定律」线索——这正是「用人类视频数据喂养机器人基础模型」这一路线的关键假设。算力口径上,Figure 称已累计为 Helix 系列投入约 35 亿美元;Index 数据引擎每秒可生成约 35 分钟等效人类行为序列。
为什么重要:具身智能过去两年的叙事是「演示很酷、泛化很难」:换一个房间、换一套家具,策略就崩。Helix 2.5 的价值在于把「零样本泛化」第一次放到 30 个不可控真实家庭的评测里,并给出可比较的数字(56%)。它同时验证了「数据引擎」的重要性——如果每秒数十分钟的等效行为数据可规模化生产,机器人的瓶颈将从「模型架构」转向「数据与评测基建」。56% 不是一个高数字,但它的对比基准是随机初始化的 6 倍,而且评测环境是真实的陌生家庭,这比实验室跑分更有说服力。
影响与观察:观察 56% 在更长任务与更多家庭上的稳定性、失败模式分布(是抓取失败还是规划失败),以及 Figure 的量产与商业部署节奏。对国内具身公司而言,值得对标的是「数据引擎 + 缩放定律」这套话语:行业竞争正在从 Demo 对比转向数据生产与评测方法论的对比。
6. Anthropic 重做 Claude Code Projects:一个协调智能体管理多个云端线程
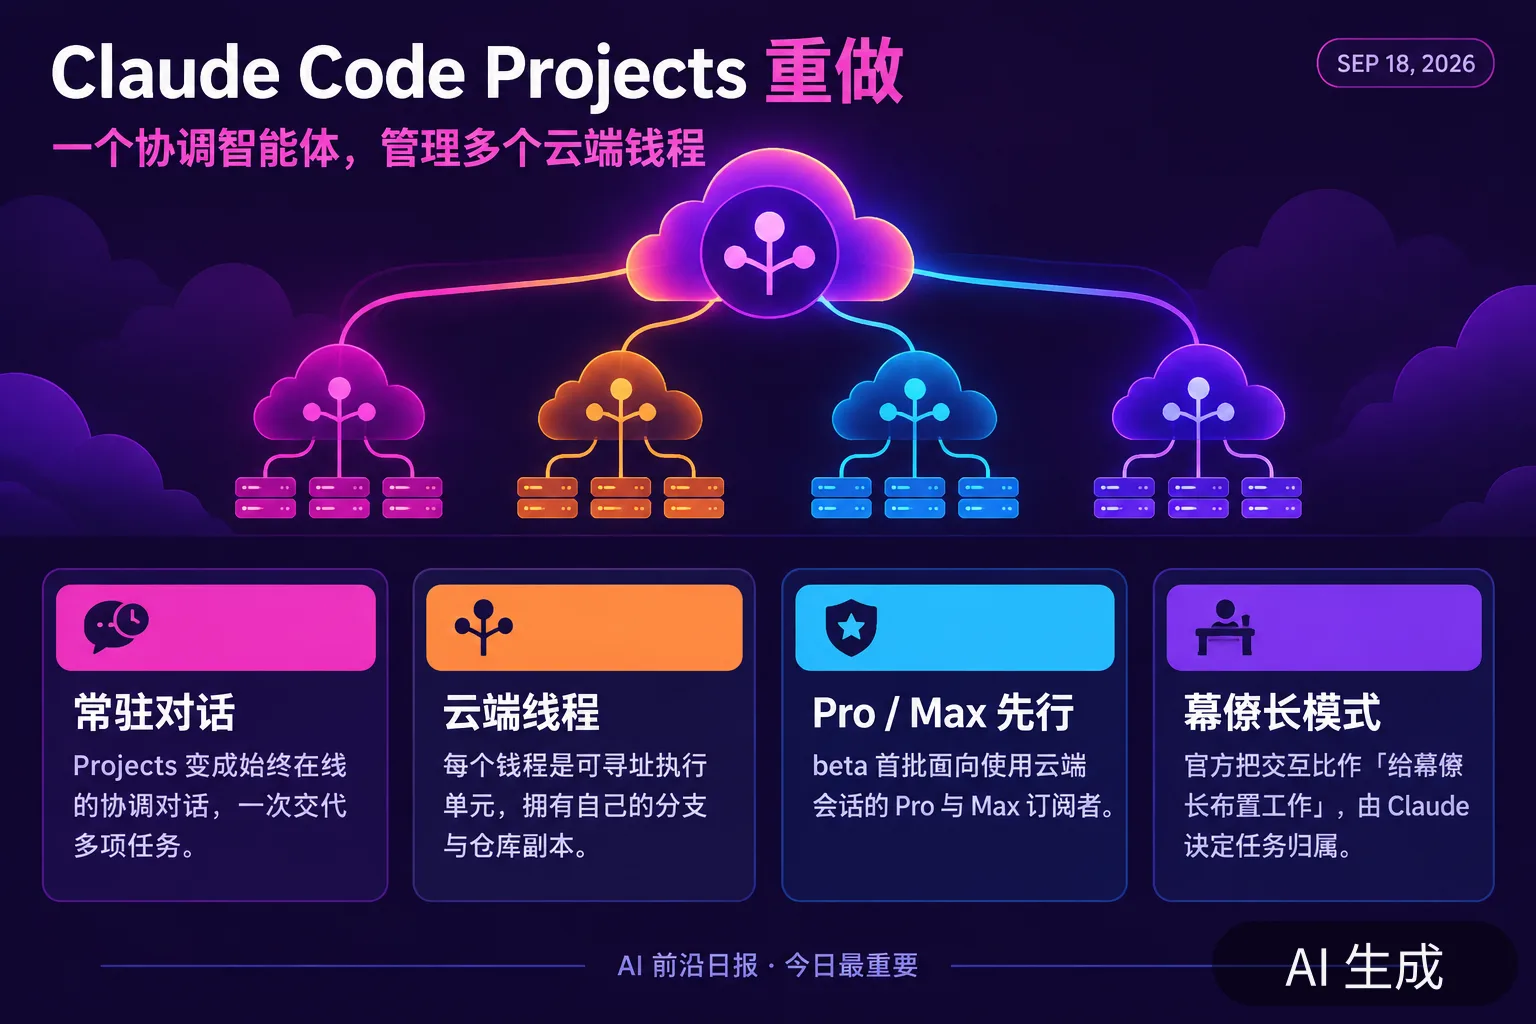
发生了什么:Anthropic 上线重新设计的 Projects(beta):从「文件夹式工作区」变成「常驻对话」。用户一次交代多项任务,由 Claude 充当协调者——判断每条请求应该放进新线程还是既有线程,并负责界定范围、并行推进、审查产出、拼装最终结果。官方把这种交互比作「给幕僚长布置工作」;每个线程是可寻址的执行单元,运行在云端、拥有自己的分支与仓库副本,对话本身持续在线、跨会话保留上下文。首批向使用云端会话的 Claude Pro/Max 订阅者开放(且是尚未用过旧版 Projects 的用户),本地开发者暂不覆盖,后续再扩大。同期 Claude Code 客户端连续发布 v2.1.275/2.1.276(排队消息一次发送、账户技能同步、代理网关回归修复),「一个 Claude」的整体方向是把多会话编排收拢进单一入口。
为什么重要:编码智能体的竞争焦点正在从「单会话能力」转向「多会话编排」——一个真实的长周期项目天然是并行的:修 bug、写测试、重构与评审同时进行。把「线程」做成拥有独立分支与仓库副本的第一类对象,意味着 Claude Code 在把「多智能体协作」产品化,而不是依赖用户自己开多个终端。它对标的是 Vercel、Cursor、OpenAI 各自的编排产品线;对开发者而言,「谁负责判断任务归属、谁负责收敛产出」这层协调逻辑是否可靠,将直接决定这类长周期工具能不能被信任。
影响与后续观察:观察 beta 扩展到本地会话与其他档位的时间表、「协调者」判断失误时的手动干预机制、以及多线程并发下的计费与额度设计。另一个观察点是生态:当 IDE、CLI、云端会话都被同一个「常驻对话」贯通时,第三方 harness 的空间会被进一步压缩。
7. 智谱发布 GLM-5.3-FlashX:200 tokens/s、定价提至 2.5 倍,港股当日涨超 5%
发生了什么:智谱正式发布 GLM-5.3-FlashX 并全面开放 API:峰值输出速度最高 200 tokens/s,较 GLM-5.3-Flash 提升约 5 倍,定价相应提高到原版本的 2.5 倍。官方称由 10 万张国产芯片组成的推理集群「上线即被用户用满」,公司正继续扩大算力规模以承接需求;并强调 FlashX 在保持同尺寸模型领先智能水平的同时,把推理速度与单位时间吞吐作为核心卖点。消息带动港股「大模型第一股」智谱股价一度上涨 5.34%。产业解读普遍认为,这是国产大模型竞争逻辑的一次切换:从「拼能力上限」转向「在同等智能水平下比拼推理效率与用户体验」——而 FlashX 的「提价」也第一次验证了高需求场景下的定价权。
为什么重要:过去一年国产模型的主旋律是降价(多模态 API 价格断崖式下跌、Flash 档价格战);FlashX 是反方向的信号——当推理集群上线即满、需求持续超预期时,厂商开始用分层定价(速度溢价)来管理稀缺算力。这与 Nebius 年内二次上调 GPU 租金、GLM-5.3-Flash 以匿名模型 6 天 62 万亿 token 的调用数据是同一条产业链证据:需求侧的真实强度正在通过价格显现。对开发者而言,「快版 + 贵版」的分层意味着选择逻辑变化:延迟敏感型任务(实时交互、批量处理)与成本敏感型任务将走向不同的模型档位。
影响与后续观察:观察 FlashX 的稳定性(200 tokens/s 是否为峰值)、按速度分层的定价是否成为行业惯例,以及智谱扩容后的集群利用率曲线。更长期看,如果「速度溢价」被市场接受,国产模型的变现结构将从「token 量 × 单价」转向「任务价值 × 时间窗口」。
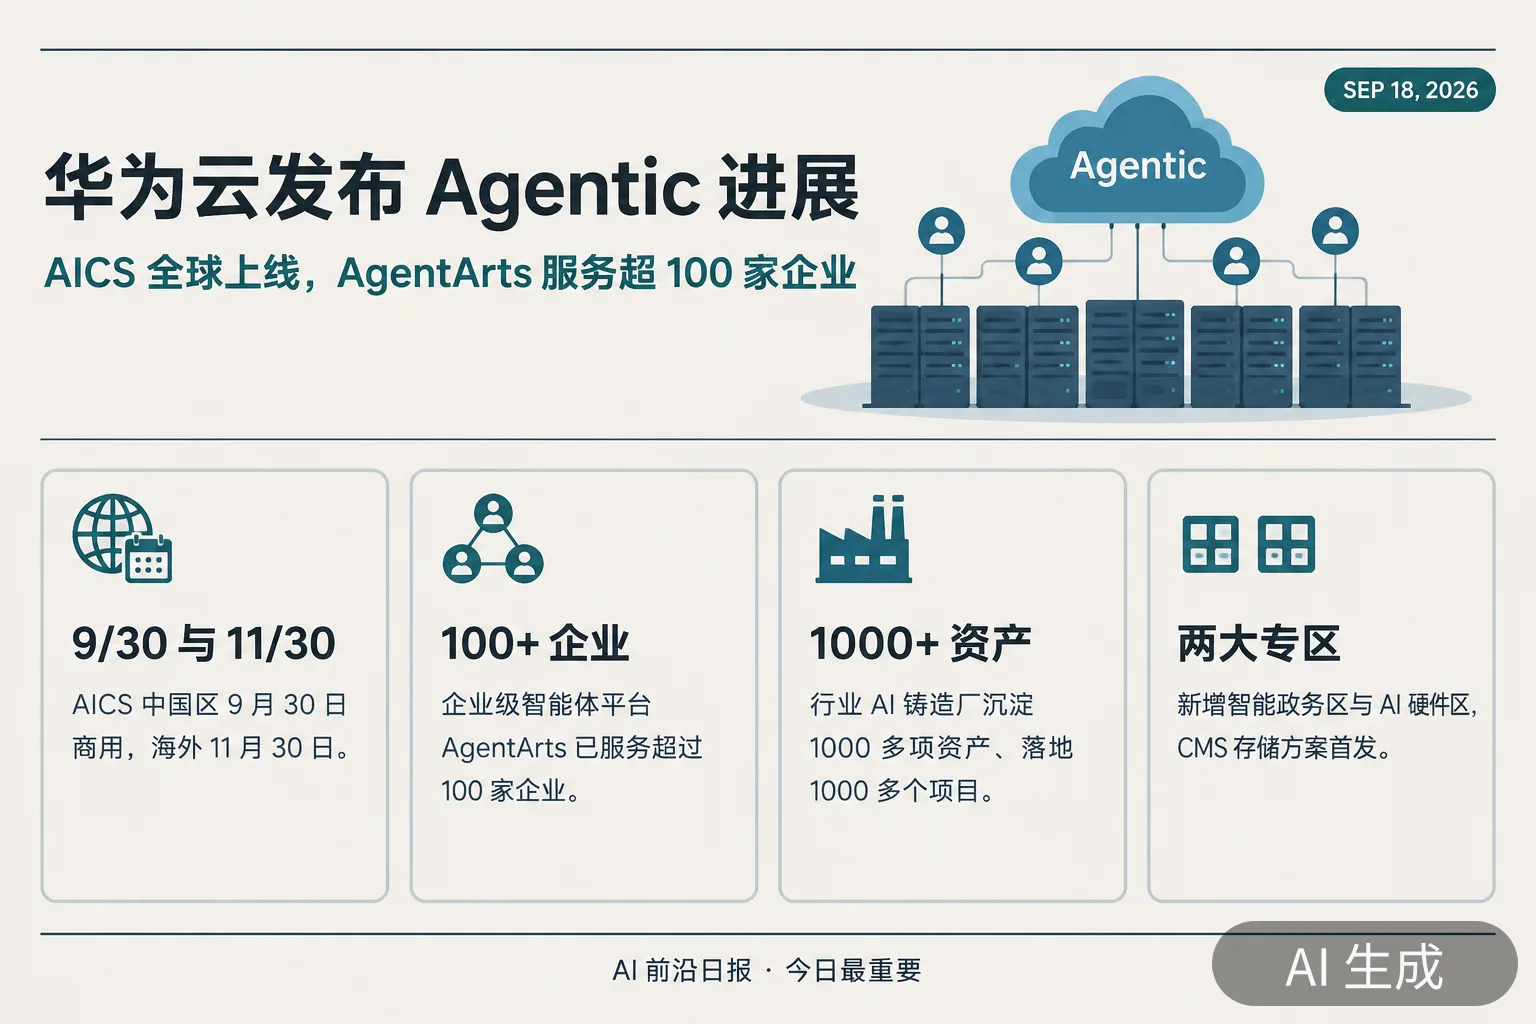
8. 华为云在 HC2026 发布 AICS 全球上线与 Agentic 平台进展:AgentArts 服务超 100 家企业
发生了什么:华为全联接大会 2026 第二天,华为云 CEO 周跃峰发布面向「Agentic 世界」的全线进展:最新 AI Cluster Service(AICS)全球上线,中国区 9 月 30 日商用、海外 11 月 30 日;首发 Context Memory Storage(CMS)方案;Agentic MaaS 平台支持一键调用多家头部模型、免部署;企业级智能体平台 AgentArts 已服务超过 100 家企业;行业 AI 铸造厂累计沉淀 1000 多项行业资产、落地 1000 多个项目,并新增「智能政务区」与「AI 硬件区」两个专区。这是在昇腾 960 超节点与 3D 数据中心发布之后的第二天——硬件的账本(互连、内存、缓存)之后,华为云把重点放在把算力封装成可交付的企业级 Agent 服务:集群服务、上下文记忆存储、模型即服务、行业资产四个层次同时商业化。
为什么重要:超节点解决的是「能不能训练和推理」的问题,Agent 平台解决的是「谁来用、用来做什么」的问题。华为云把「Context Memory Storage」单列为产品是一个值得注意的技术判断:智能体时代最贵的不是算力本身,而是长上下文记忆的存储与检索——把 KV 缓存与记忆层做成独立基础设施,与昨天公布的 PB 级 KV 缓存方案(OceanStor M900)呼应。行业资产「1000+ 项、1000+ 项目」的口径说明其打法不是通用平台,而是「行业构件复用」:政务、硬件两个新专区直指地方政府与制造业的预算盘子。
影响与后续观察:观察 AICS 的实际交付规模与客户名单、AgentArts 从 100 家企业向更大规模复制时的单位经济性,以及「智能政务区」在各地数字政府建设中的落地节奏。对国内云市场而言,华为云正以「国产算力 + Agent 平台 + 行业资产」三件套对打阿里云的 MaaS 路线,竞争维度从模型清单转向交付能力。
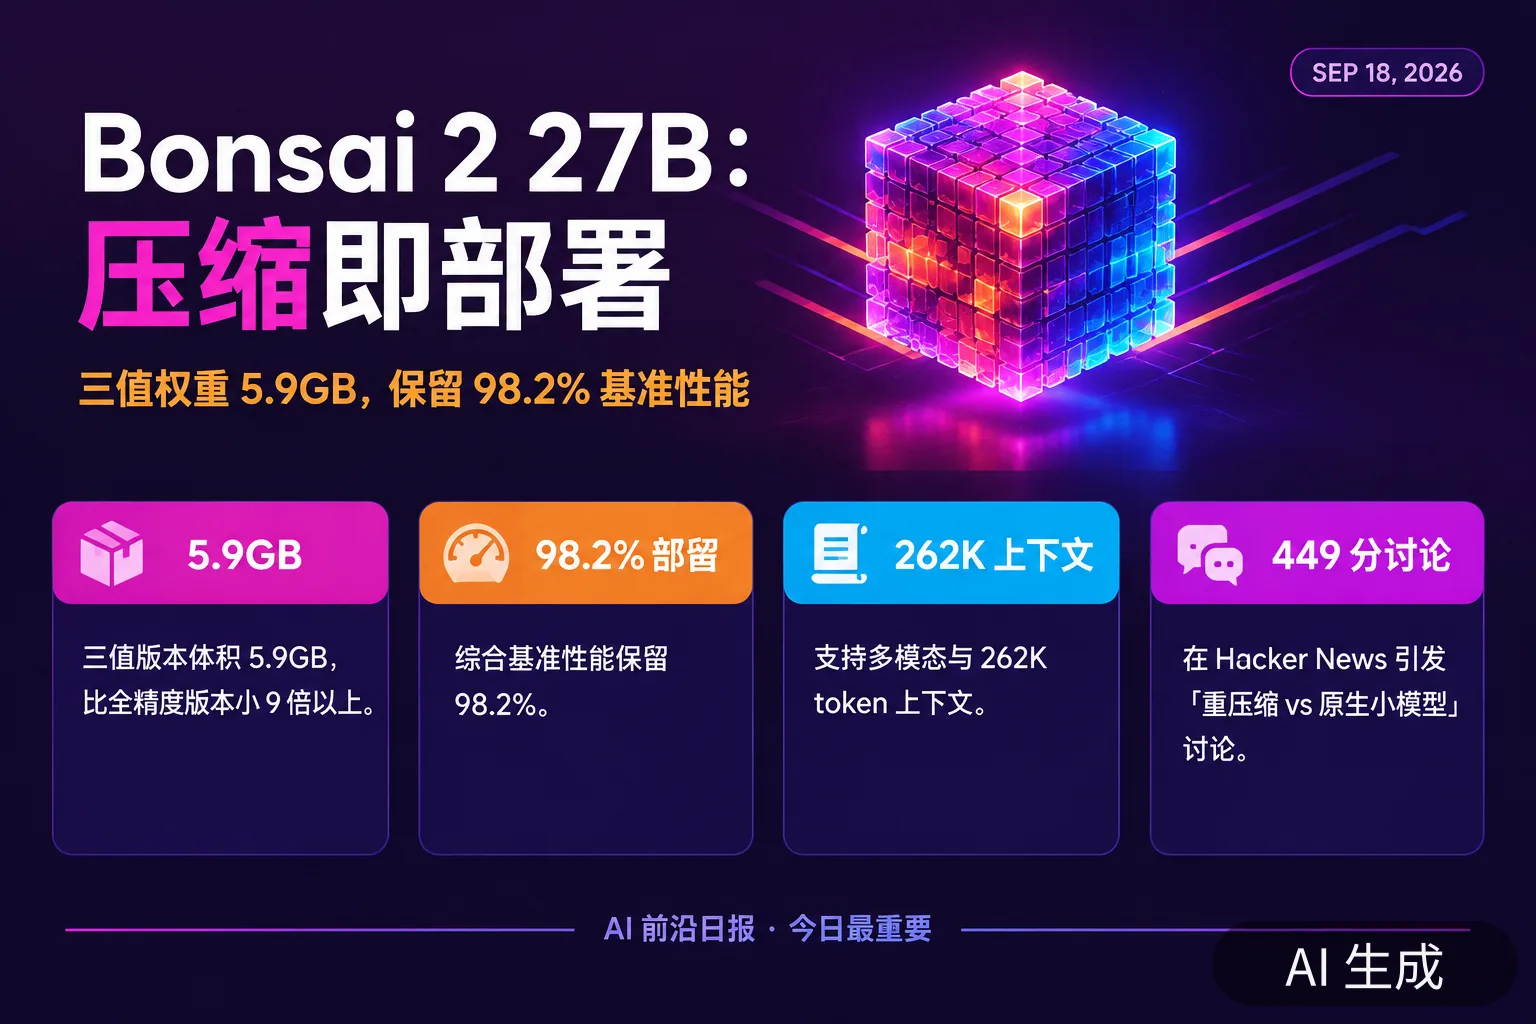
9. PrismML 发布 Bonsai 2 27B:三值量化压到 5.9GB、保留 98.2% 基准性能
发生了什么:PrismML 发布 Bonsai 2 27B:对 Qwen3.8 27B 做二值/三值权重压缩,三值版本体积 5.9GB、比全精度版本小 9 倍以上,同时保留 98.2% 的综合基准性能,支持多模态与 262K token 上下文。官方把它定位为「压缩成为部署解锁」——接近原模型的能力,却可以跑在远比原来更多的地方。配套 GGUF 权重上线 Hugging Face 后进入趋势榜(536 赞),并在 Hacker News 引发关于技术路线的讨论(单条 449 分):是继续把压缩推向极限,还是等待原生小模型变强?
为什么重要:这条新闻与 DeepSeek 的 KV 缓存压缩、GSQ-RCO 等社区量化格式、以及「端侧 AI」的热度拼在一起,构成一条被低估的主线:大模型的「部署形态」正在分化——同一代能力,通过压缩可以进入手机、消费级显卡与个人工作站。它的经济含义是:如果部署成本下降 9 倍且性能损失仅 2%,那么「本地跑 27B 级别模型」从极客实验变成普通选项;对云厂商而言,这既是客户流失风险,也是边缘推理市场的开闸。
影响与后续观察:观察三值权重在长任务(编码、Agent 链)上的实测衰减(综合基准 98.2% 不代表所有任务同比例保留)、以及对硬件(GPU/NPU 指令支持)的要求。另一个观察点是法律与许可:基于开源权重做重压缩再分发的模式,正在成为开源生态的常规操作,其许可边界值得持续跟踪。
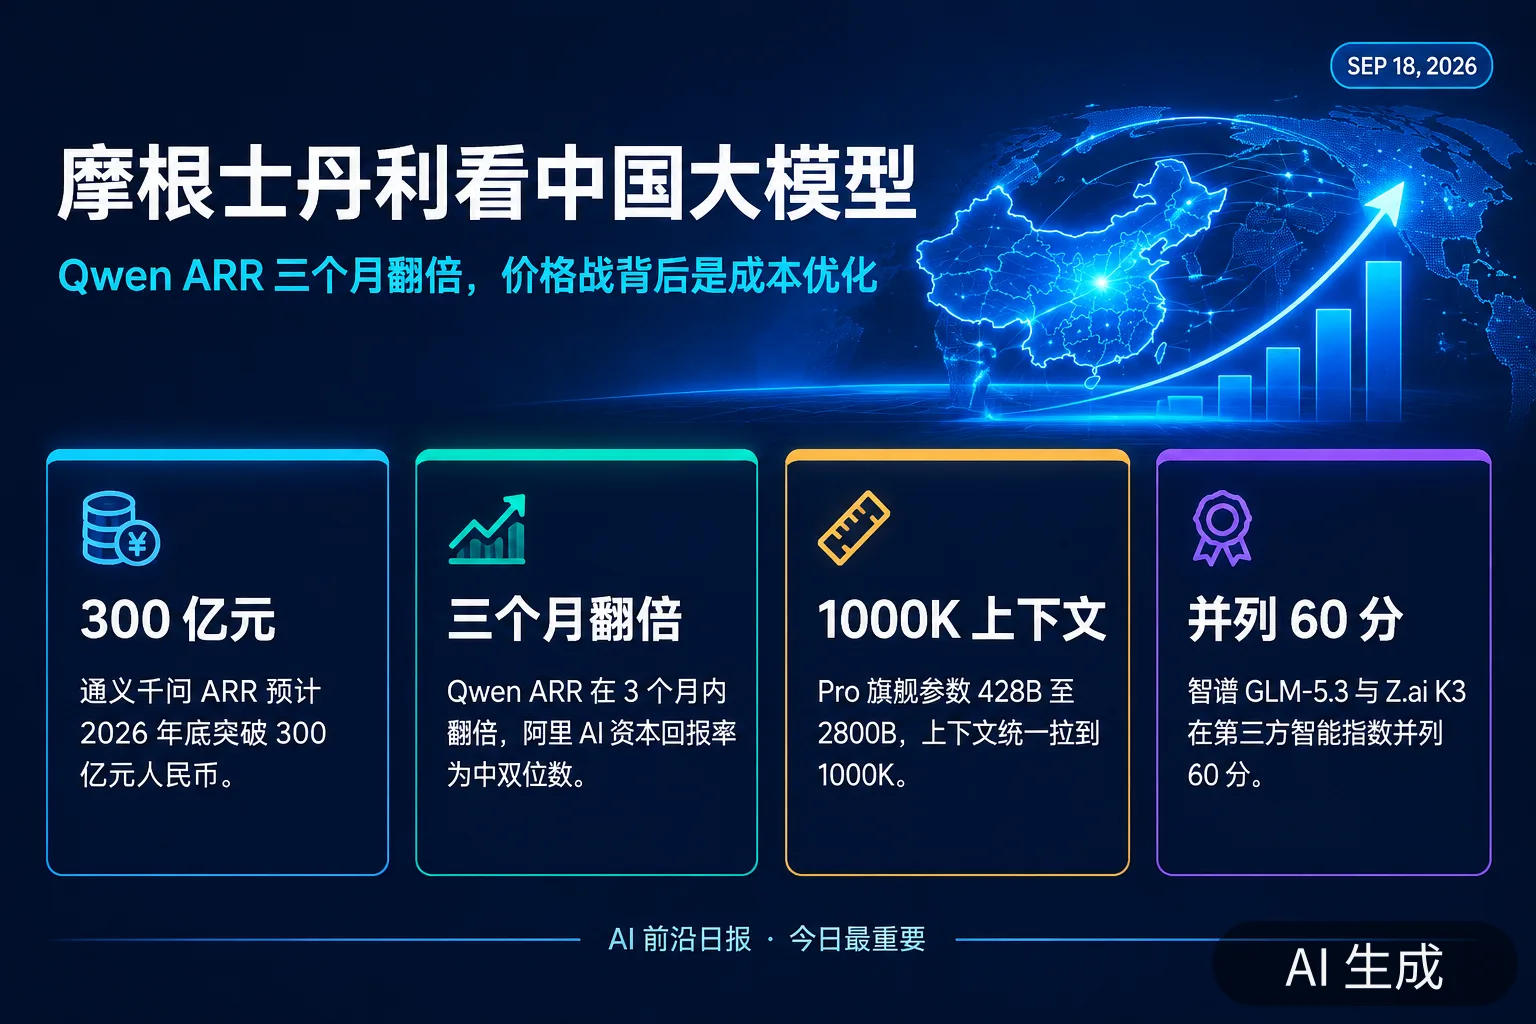
10. 摩根士丹利《中国 AI 之路》报告:Qwen ARR 三个月翻倍、年内将破 300 亿元
发生了什么:摩根士丹利发布《中国 AI 之路:大模型》报告,给出中国大模型产业的竞争图景:中美模型能力差距快速缩小、已具备大规模商业化基础;多模态 API 价格在 2025Q1–2026Q3 间断崖式下跌,背后是底层算力与推理成本的实质优化。具体数据包括:通义千问 ARR 在 3 个月内翻倍、预计 2026 年底突破 300 亿元人民币;阿里全栈 AI 布局(IaaS+PaaS+MaaS)的资本回报率(ROIC)为中双位数、投资回收期小于 3 年;Pro 级旗舰参数从 428B 到 2800B、上下文统一拉到 1000K;智谱 GLM-5.3 与 Z.ai K3 在第三方智能指数评分并列 60 分;MiniMax M3 以 428B 参数和最低定价主打落地门槛。报告的结论是:国产大模型正从参数竞赛走向产业落地的实战阶段。
为什么重要:这份报告把「中国模型」的评估坐标从「能力榜第几」切换到「赚了多少钱、花了多少钱」:ARR 翻倍、ROIC 中双位数、回收期小于 3 年在资本叙事里是第一次出现的组合。同时它给出了结构判断——阿里靠全栈吃到了最大份额的商业化红利,腾讯押注生态内应用,而「价格战」被重新定义为成本优化的结果而非烧钱补贴。它与同日另一组数据(见中国 AI 动态:中国头部模型收入约为 OpenAI 与 Anthropic 合计的一成)形成张力:用量与估值领先、收入落后,正是下一阶段要回答的问题。
影响与后续观察:观察 Qwen ARR 的官方口径与年底兑现情况、Pro/Flash 双轨的定价演化,以及「单位经济性」能否在更多厂商身上被验证。对行业而言,报告隐含的另一个判断是:中国市场的胜负手不在模型参数,而在「谁能把推理成本的下降转化为可计费的交付」。
大模型与 API 更新
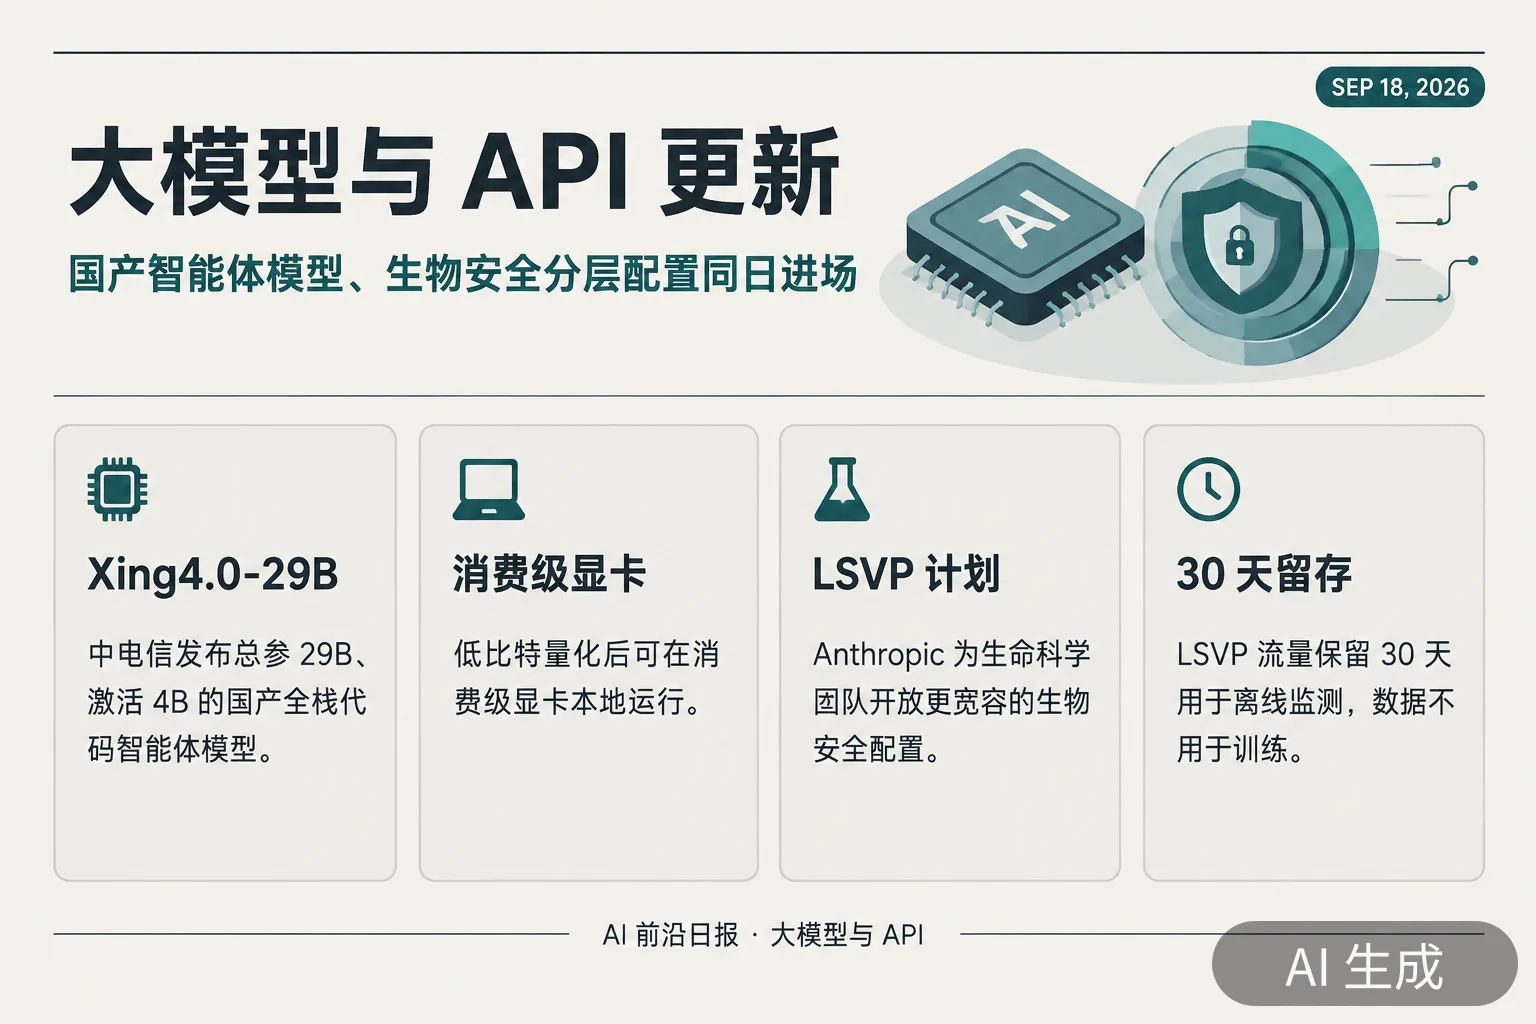
中电信发布星辰 Xing4.0-29B-A4B:国内首个全栈国产算力训练的百亿级代码智能体模型:中电信人工智能科技有限公司发布新一代星辰大模型 Xing4.0-29B-A4B,采用 MoE 架构、总参数 29B、激活参数仅 4B,是国内首个基于国产算力和国产框架完成训练、面向复杂工程任务深度优化的百亿参数大模型。模型聚焦任务理解、规划、工具调用与自主执行,通过低比特量化把显存占用大幅降低,可在消费级显卡本地运行;兼容主流训练、推理与智能体框架,并完成多种国产及主流 AI 芯片平台的适配验证,权重已上线 GitHub、Hugging Face、Gitee、魔搭、魔乐等社区。发布次日进入 Hugging Face 趋势榜(372 赞),「会回答」到「会做事」的定位与 X4.0 系列是同一产品线逻辑:把智能体能力下沉到轻量硬件。
Anthropic 上线生命科学验证计划(LSVP):为受验证团队开放更「宽容」的生物安全配置:通过资质审核的生命科学团队可在 Mythos、Opus、Sonnet 模型上获得面向生物研究更宽容的分类器配置,覆盖药物发现、研究生物学、临床开发与制造等此前被通用版拦截的任务。计划分「标准使用」与「高风险使用」两类授权:前者可扩展至整个团队、每年续期;后者针对单一项目、每六个月续期,会移除生物领域拦截分类器(Mythos 的高风险授权目前仅限少数经额外审查的机构,并与美国政府协调)。监管方式从实时拦截转向离线监测:要求 LSVP 流量保留 30 天数据用于识别跨请求的滥用模式(数据严格隔离、不用于训练),并与企业 CISO 协作定义「安全使用范围」。这是「可信访问」模式在生物域的落地样本——安全边界不再是一刀切的开/关,而是按主体资质分层的可编程配置。
论文与研究前沿
DeepSeek 技术报告:把 V4.1-Flash 的 KV 缓存压缩推到极限:DeepSeek 公开 V4.1-Flash 的 KV 缓存压缩技术报告,围绕「因果编码-解码器(CED)」架构与不对称动态激活,系统探索把长上下文推理的显存占用压到低位,同时维持百万级上下文与多模态输入的可服务性。此前公开数据显示该模型把 KV 缓存压缩至每 Token 约 890 字节量级;这份报告把「单位显存能服务多少上下文」变成可复现的工程对照,对推理成本敏感的长上下文服务是直接参考。
SoL-Pi:把「自动研究循环」递归扩起来,为 Agent Harness 提效:论文用递归扩展的自动研究循环为智能体 harness 做优化:让研究流程本身可被搜索与复用,把「为一个 harness 找到好配置」从人工试错变成可规模化的循环。与同期「harness 设计实证研究」形成呼应——当模型能力趋同,围绕它的脚手架正在成为可被系统性优化的对象。
An Empirical Study of Harness Design for Coding Agents:编码智能体成绩里 harness 占多大比重:系统实证研究编码智能体的 harness 设计:工具集、上下文管理、权限与反馈回路的差异如何影响同模型下的任务成绩与成本。这类把 scaffold 变量单列的研究正在成为评估标准的一部分——榜单分数需要区分模型能力与脚手架红利。
When EOS Tokens Disagree:在策略蒸馏里的「长度膨胀」从哪里来:研究在策略蒸馏中的长度膨胀现象:当教师与学生在 EOS(序列终止)判定上不一致,学生的输出长度被系统性拉长、拖累训练稳定性与推理成本。作者给出判定与缓解路径,对把蒸馏当低成本提升手段的团队有直接工程价值。
JEPA-Anything:跨「世界」学习预测模型:论文把联合嵌入预测架构(JEPA)的思路推广到不同数据与任务「世界」:统一训练预测模型,使其在不同模态与环境的表示空间学习可迁移的动态规律。这是非生成式表征预测路线在多域设置下的一次扩展,对世界模型与机器人学习都具参考意义。
RetireOPD:会「自我退休」的在策略蒸馏,用于智能体强化学习:让在策略蒸馏在智能体 RL 中按需「自我退休」——当学生策略已吸收教师指导后自动退出蒸馏信号,避免长期蒸馏带来的探索压制与分布固化。与近期一批「蒸馏何时帮倒忙」的研究共同指向:蒸馏是有明确启停时序的训练组件,而非全程常开的正则。
Quantifying Overclaiming Propensity in Frontier LLM Agents:前沿智能体的「过度宣称」倾向被量化:论文建立可度量的「过度宣称」指标:当任务结果不确定或未完成时,智能体在报告中对成功的宣称程度。在多智能体与长程任务里,「自称完成」的偏差比单次问答错误更隐蔽——这类测量直接服务于评估与运维。
Deep Noir:用「架构计时学」自主发现 Transformer 里的引导方向:论文通过对模型内部各层计算的时间/激活特征做系统化对比(作者称之为 architectural chronometry),自主发现可用于引导生成的方向向量,把「激活转向」从人工枚举推进到自动搜索。可解释性与控制方向的自动发现,是当前安全与调优共同关心的接口。
Coding Agents with an Obstacle-Aware Harness:让编码智能体安全地驱动机器人操作:论文为编码智能体加装「障碍感知」harness,使生成的操纵代码在真实约束(避障、碰撞、可达性)下可执行并自检。这是「coding agent 走出屏幕」的现实路径——用工程约束而非端到端策略接管物理执行。
Can 4D Foundation Models Remember?:4D 基础模型的「记忆」能力被系统测评:针对 4D(三维+时间)基础模型提出记忆能力评测:动态场景理解需要模型在时间轴上保持对象与状态一致,而当前模型在遮挡、再现与长序列上的表现此前缺乏统一测量。这是「世界模型」叙事落地前必须补上的一课。
dQwen3.5:混合注意力的扩散语言模型:在 Qwen3.5 架构上构建的扩散语言模型,把注意力机制在「双向去噪」与「因果生成」之间做混合设计,试图弥合扩散式文本生成与主流自回归栈的差距。一份把扩散接进成熟模型家族的现实路径。
RAFT:面向故障排查智能体的有状态检索增强框架:为故障排查场景设计带状态的检索增强,把诊断过程中的证据与假设跨轮次保存,避免每轮从零检索。运维/工单类智能体是 RAG 落地的重灾区——「状态」而非「召回率」常是性能瓶颈。
Workspace Models:用显著性监督做轻量机器人记忆:给机器人策略配一个轻量的「工作区记忆」,以显著性驱动的监督决定保留哪些观测,从而在长程操作任务中低成本维持环境状态。具身智能的记忆问题正在从「堆上下文」转向「选择保留什么」。
Anthropic:Claude 四周把 30 多个开源生物分子模型平均加速约 4 倍:Anthropic 公开使用 Claude 优化开源生物分子建模工具链的结果:不到四周优化 30 多个科学家常用模型、平均加速约 4 倍,并加入低显存模式,使超过 10000 tokens 的生物分子系统(氨基酸、核苷酸、小分子与离子)可在单台 NVIDIA GPU 节点上完成预测。全部优化代码已开源,并与 Adaptyv Bio 合办蛋白设计竞赛:提供最高 100 万美元 Claude 额度、Modal 25 万美元算力与 5000 多个设计的湿实验室验证资源。该案例与 LSVP 计划同日发布,构成科学场景的双线推进——一边扩容能力,一边用竞赛与验证闭环把「AI 做科学」变成公共行为。
开源项目与 GitHub 热点
Tencent BrowserSkill:让智能体使用你「已登录」的真实浏览器:腾讯开源 BrowserSkill,让 AI 智能体直接使用用户真实、已登录的浏览器完成任务,且不打断用户工作。它切入的是智能体落地最现实的瓶颈之一——大多数网页任务依赖账号与会话状态,而沙箱浏览器要么无法登录、要么触发风控。把「真实浏览器」做成可授权的技能,是「计算机使用」代理进入日常操作的一条务实路线。
腾讯 WeKnora:把原始文档变成可查询 RAG 的开源知识平台:腾讯开源 WeKnora,把原始文档转成可查询的 RAG 与智能问答服务。在企业知识库成为智能体「事实源」的当下,检索层的开源实现(解析、切块、检索、评测)正在与 Agent 框架一起构成组织内部智能体的标准底座。
腾讯云 Octop:自托管的多用户多智能体 AI 助手:可自部署的多用户、多智能体 AI 助手,主打在组织内提供「更聪明的自托管助手」形态。结合同日趋势榜上的 BrowserSkill 与插件化风潮,大厂正在把「智能体 + 技能 + 真实权限」打包成可安装的组织内部件。
affaan-m/ECC:给智能体 harness 做「性能优化系统」:ECC 定位为智能体 harness 的性能优化系统:技能、本能、记忆与执行策略的组合调优,直接瞄准「同一个模型换个 harness 成绩差多少」这一被反复验证的现实。harness 优化正在从个人技巧变成开源资产——与本周的 harness 学术研究互为呼应。
7 名博士生 3 个月从零训练 7B 模型 ZGCM-1:代码、数据与训练日志全部公开:中关村学院团队公开 ZGCM-1 的训练全流程,并把代码、数据与训练日志全部开源。在「规模化训练黑箱化」的行业背景下,这类端到端透明复现材料对研究社区的教学与复现价值很高,也让「小团队能走多远」有了新的参照点。
Unsloth v0.1.810-beta:Docker 化、多用户与 AMD 支持进入测试版:Unsloth 将微调栈进一步 Docker 化,加入多用户支持与 AMD 平台适配。开源微调工具链正在补齐「团队服务器上开箱可用」的拼图,与 llama.cpp、colibri 等本地推理路线形成从微调到部署的完整闭环。
Hugging Face 模型、数据集与 Demo
趋势榜 9 月 18 日快照:DeepSeek-V4.1-Flash 居下载与点赞前列,「重压缩」权重持续入场:DeepSeek-V4.1-Flash 以 39 万下载、3073 赞居前;Qwen3.8-27B 以 1558 万下载、15584 赞维持开源主力地位;端侧与轻量权重持续入场——NeoHorse-1-4B(2355 赞)、Edge0-35B-A3B-preview(3353 赞)、Agnes-3.0-Flash、MiniCPM5-2B 等都在前列;新入场者包括 Ternary-Bonsai-2-27B 与中电信 Xing4.0-29B-A4B。端侧化与「重压缩」两条路线在榜单上并行攀升。
社区微调:Qwen2.5-1B 经 RLCD 方法改造后进入趋势榜:社区作者用 RLCD(强化学习与对比蒸馏结合)方法微调 Qwen2.5-1B,权重上线后快速获得 331 赞。1B 级模型的「小改进、快扩散」节奏说明:在 API 价格战之外,本地可跑的迷你模型仍有稳定的实验人群。
UltraData 智能体数据发布 2609 新批次:RL 版与 SFT-Agent 版同日入场:openbmb 的 UltraData 系列更新 2609 批次,RL 与 SFT-Agent 两个版本同时进入趋势榜(分别 149 与 188 赞)。智能体训练数据的供给节奏正在跟随强化学习训练的扩张——数据团队按「训练批次」发数据,越来越像模型发布本身。
Spaces 趋势:视频与图像生成类 Demo 领跑,Wan2.2 量化预览版居前:Spaces 趋势榜由视频/图像生成类应用领跑(Wan2.2 FP8 量化预览版 3123 赞,图像编辑类 Omni-Image-Editor 仍在榜),笔记类(Lynote/ai-notes)与音频/音乐 Demo 同步靠前。消费端多模态工具的「即开即用」需求,正在把 Spaces 变成模型能力的公共展厅。
Agent / AI Coding / 开发工具
OpenAI Codex CLI 发布 0.155.0 正式版:终端内实验性语音对话、macOS Touch ID 验证 MCP:新增实验性 /voice 语音对话(实时转写、麦克风控制,经 /experimental 开启)、TUI 状态栏实时推理摘要与完成时间戳、agents 总览的任务隐藏/归档/删除与 worktree 归属信息;macOS 支持 Touch ID 验证 MCP 请求;app-server 守护进程支持可配置自动更新、重启后恢复线程与目标;Amazon Bedrock 支持从命令获取 AWS 凭据并自动刷新。安全侧修复了 WSL 沙箱逃逸、加固凭据快照、完善 MCP OAuth 过期提示;Python SDK 与 CLI 发布流程对齐,0.156.0-alpha 已开始迭代。语音进终端是「编码智能体多模态化」的最新一步。
Claude Code 发布 v2.1.275 与 v2.1.276:2.1.275 带来 ctrl+enter「立即发送」——打断当前回合并把排队消息一次性送出;把 claude.ai 账户已启用的技能与插件同步到终端会话(可关闭);插件安装支持指定 marketplace 源;以及大量 TUI/VS Code 修复与安全加固(npm 源插件改用 npm pack --ignore-scripts 并做完整性校验、服务器托管设置变更需审批)。2.1.276 为紧急修复:代理网关场景下因 advisor 输入标签导致的 400 报错(2.1.275 回归)。「排队消息」与「技能同步」都是高频工作流细节,说明竞争已深入到日常手感层面。
openai-python v3.15.0 发布:官方 Python SDK 延续本周 v3.14.1 后的高频迭代,配合 Codex/API 侧能力(含语音与 agent 运行时相关接口)保持同步。
Gemini CLI 推进到 v0.62.0-nightly.20260918 夜间构建:Google 命令行智能体保持每日夜间构建节奏,v0.62.0 线进入 9 月 18 日构建。命令行的更新频率已成为 Google 对开发者侧的稳定输出通道。
pydantic-ai v2.45.0 发布:类型安全智能体框架两天一版迭代,1.x 维护线同步更新。Agent 框架层的竞争已从「能不能做」转向 API 稳定性与类型契约的工程体验。
Block 的 goose v1.51.0 发布:作为最早把「本地执行 + 多模型」做成桌面体验的开源编码智能体之一,goose 的稳定迭代继续支撑「智能体作为可安装工具」的产品化路线。
Cline Desktop v0.0.32 发布:Cline 延续「CLI + 桌面 + SDK」多形态推进。桌面端智能体正在成为 IDE 插件与终端 CLI 之外的第三个入口。
Vercel AI SDK:ai@7.0.106 更新,@ai-sdk/zai 与 @ai-sdk/xai 适配器同日发版:主线与 6.x/5.x 维护线同日更新,并发布 Z.ai(智谱)与 xAI 的官方适配器版本。中国模型在国际 SDK 生态里的「一等公民」位置在加固——适配器与模型发布同频,意味着国际开发者接入中国模型的门槛持续降低。
LangChain 预览发布 langchain-typesafe 包:新包 0.0.1a1 → 0.0.1a2 同日两次迭代。「类型安全」正在成为 agent 框架的共同方向:把工具调用与状态流转纳入静态检查,降低长链路智能体的运行时不确定性。
n8n 发布 n8n@2.39.8 稳定版:工作流自动化平台稳定版更新(2.40.3 在 beta 线推进)。作为「人人可用」的自动化层,n8n 的节奏反映工作流与智能体编排在企业侧的持续渗透。
多模态、视频、语音、图像
Qwen3.8-Omni-Flash 配套开源细节:插件适配主流 harness,长视频理解转向「按需感知」:团队开源 Qwen-MM-Plugins(支持 Codex、Claude Code、Qwen Code、Gemini CLI 等)与实时运行环境 Qwen-Live Harness;面向数小时视频的「Agentic 长音视频理解」不再逐帧处理,而是从问题出发、由粗到细多轮取证定位关键信息,大幅削减 token 消耗。加上「12 小时把 Qwen2.5-Omni-3B 四川话识别字符错误率从 25.79% 降到 15.30%」的自主优化案例,通义把「大模型做研发、小模型面向业务」当成明确范式。
QuiverAI 发布 Arrow 2:面向设计与动画的矢量(SVG)生成模型:新模型主打更快的生成与更强的设计直觉,在动画、矢量化与素材创建上大幅改进,可生成、编辑并制作 SVG 动画。矢量设计是图像生成之外被低估的「可编辑交付物」赛道——输出直接进入设计工具链,而非像素图。
豆包座舱助手发布:与上汽合作,首款车型荣威家越 07 于 9 月 21 日开启预售:字节豆包与火山引擎联合打造的 AI 原生车载助手正式发布,已与上汽集团达成合作;上汽奥迪相关车型年内亮相,后续将实现与豆包 App 的手车互联。大模型入口正在从手机/PC 延伸到座舱,「车」成为 Agent 化交互的新终端。
算力、推理、芯片与基础设施
Tower 半导体与 NewPhotonics 开始规模化出货 AI 光引擎 PIC:单通道 200G、支持 800G–1.6T:双方宣布大批量交付用于 AI 数据中心互连的「激光集成、可维护」光引擎光子集成电路:NPG102 基于 Tower PH18DA 硅光平台,单通道速率 200G,支持 800G 至 1.6T;采用异构集成把激光器、SOA、调制器与探测器单片集成;面向 6.4T NPO 应用的 CPX-MSA 芯片组计划 2027 年上半年量产。消息带动 Tower 股价上行——光互连的量产爬坡是超节点与机架级系统的关键供应链信号。
Nebius 自 10 月 1 日起再度上调按需 GPU 租金:年内第二次全面提价:海外算力租赁公司 Nebius 拟自 10 月 1 日起再次上调按需 GPU 租金,券商点评认为「长约、短约、按需」价格全线上移,说明算力紧缺正从叙事走向报表。同日 A 股算力硬件走强:创业板算力基础设施指数午后拉升超 2.6%,多只算力 ETF 本周密集上市(8 只合计约 50.58 亿元)。
联想 AI 服务器在手订单升至 3600 亿元,港股半日涨超 7%:联想集团披露 AI 服务器储备订单由上一财季的 1400 亿元大幅提高至 3600 亿元;首财季 AI 相关业务收入同比增长 60%、达 634 亿元创历史新高。受黄仁勋「明年芯片销量翻倍」与费城半导体指数大涨 3.14% 带动,联想半日升 7.46% 领涨蓝筹。整机厂的 AI 服务器交付能力正在被资本市场重新定价。
SEMI 预测:2026 年全球 300mm 存储厂设备投资达 520 亿美元、同比增长 29%:SEMI 预计 2024–2029 年复合增速约 19%;AI 驱动存储厂商加速扩产,叠加国产设备替代推进,半导体设备与零部件被机构列为关注方向。同日 A 股半导体板块走强:东微半导 20% 涨停,燧原科技-U、国民技术等涨超 10%。
Crusoe 完成 39 亿美元 F 轮融资:估值 309 亿美元,冲刺 IPO:AI 数据中心开发商 Crusoe 宣布完成 39 亿美元后期融资,投后估值 309 亿美元(pre-IPO 前一轮约 270 亿美元),资金投入数据中心与「AI 工厂」项目。资本继续向「能源+机房」层集中:当算力租金被连续上调、租约被长约锁定,基础设施资产成为 AI 资本开支周期里最直接的受益与风险承载体。
富士通 MONAKA 登上 Hacker News 头部:日本 2nm 3D 堆叠 CPU 面向主权 AI,11 月上市:这款「日本制造」2nm 3D 堆叠 CPU 主打 AI 推理性能提升 2 倍与高能效,将于 2026 年 11 月起面向数据中心运营商、企业与学术/HPC 客户销售,定位主权 AI 基础设施;评论区集中讨论 Arm 服务器生态、堆叠缓存路线与「主权算力」的可行性边界。
黄仁勋:明年芯片销量将是今年的两倍,「瓶颈不是需求而是产能」:黄仁勋在苏格兰 AI 峰会表示,随着 AI 渗透医疗、制造与金融服务,公司明年芯片销量将达今年的两倍;当前瓶颈不是需求,而是把芯片生产出来的能力。此前公司预计截至 2028 年 1 月财年营收约 6730 亿美元、增速约 70%。该表态成为当日全球与 A 股半导体行情的直接催化之一。
苹果 M8 Ultra 服务器细节曝光:双/四芯配置、评估英伟达 NVLink Fusion 互连:面向 AI 推理的服务器预计配备两颗或四颗 M8 Ultra 芯片,项目约一年前启动并获现任 CEO 约翰·特纳斯支持;芯片互连方案正在评估英伟达 NVLink Fusion。此前报道仅确认项目与洽谈存在,本次曝光了芯片配置与互连选型两条新信息——苹果自研芯片进入推理服务器的路径逐渐清晰。
中国 AI 动态
商务部:中国人工智能大模型全球累计下载量突破 100 亿次:商务部部长助理张力在国新办发布会介绍,中国 AI 相关产业快速发展、带动 AI 产品进出口增长;中国很多创新走开源路线,人工智能大模型全球累计下载量突破 100 亿次,让更多国家特别是发展中国家「用得上、用得起新技术」。这是官方口径首次把「下载量」作为国产开源模型全球影响力的量化指标。
北京新增 51 款完成登记的生成式人工智能服务,累计 246 款:截至 2026 年 9 月 18 日,北京市新增 51 款已完成登记的生成式人工智能服务,累计完成 246 款登记。备案节奏反映供给端仍在快速扩容,也意味着监管侧的「登记—合规」通道在高频运转。
地瓜机器人完成 4 亿美元 C 轮:旭日系列芯片累计出货突破 800 万片:本轮由未来资产领投,美团战投、高瓴创投等参与。官方数据:2026 年上半年营收同比增长数倍;旭日 S600 已被它石智航、千寻智能、自变量、优必选、北京人形机器人创新中心等 20 多家客户采用,具身智能客户覆盖率超 50%。作为具身智能的「芯片+开发平台」底座型公司,其融资被视作赛道量产化进展的温度计。
MiniMax 参与共建新加坡 Singtel AI 订阅套餐,股价单日涨 7.06%:MiniMax 受邀参与共建新加坡电信的 AI 订阅套餐,旗下三款 AI 产品纳入当地服务;消息带动公司股价单日上涨 7.06%,总市值 889.90 亿港元。中国模型公司出海正从「API 供给」进入「与本地运营商捆绑分销」阶段,渠道与合规能力成为新的竞争维度。
全球首个 3D 算力芯片编程模型 Open3D-PIMC 开源:清微智能与智源联合发布:在 2026 中国算力大会上,全球首个面向 3D 算力芯片的编程模型与开源软件框架 Open3D-PIMC 正式开源,全部代码已上线开源社区,成为国产自主 AI 软件栈众智 FlagOS 面向下一代 3D 算力芯片的标准化方案。3D 算力芯片把存储与计算单元纵向堆叠以破解「存储墙/功耗墙」,此次开源标志着国产 AI 软件栈从上层框架、算子层向下贯通至芯片编程与编译层。
昇腾 960 超节点更多细节:风冷/液冷版明年 Q2/Q3 上市,910C 超节点部署已超 1000 套:补充昨日发布——昇腾 960 风冷与液冷超节点将分别于 2027 年第二季度和第三季度上市,延续一年一代节奏(2028 年 970、2029 年 980);昇腾 910C 超节点累计部署已超 1000 套、昇腾 950 实现商用;NPO(近封装光学)在算力卡边缘几厘米的距离实现电转光,突破铜缆传输距离与带宽极限,用于匹配十万亿参数模型的训练与推理需求。
研究机构:中国头部 AI 模型收入约为 OpenAI 与 Anthropic 合计的一成:Rhodium Group 研究显示,中国头部 AI 模型的合计收入约为 OpenAI 与 Anthropic 两家合计的 10%;报告认为中国模型在估值与使用量上快速攀升,但收入变现仍显著落后于美国前沿实验室。该数据与「中国模型周调用量接近美国 3 倍」形成鲜明对照,凸显「使用量领先、收入落后」的结构性错位——这也是摩根士丹利报告之外,资本最关心的下一段曲线。
社区热议与争议
微软 AI 负责人苏莱曼炮轰 Anthropic:AI 威胁真实存在,而 Anthropic 正在加剧它:微软 AI CEO 穆斯塔法·苏莱曼在播客节目中批评 Anthropic 训练 Claude 的方式,矛头直指其《Claude 宪章》:他认为 AI 威胁真实存在,而 Anthropic 的做法正在加剧这种情况。围绕「模型该不该被赋予价值观章程」的路线之争,正从研究圈扩散到巨头高管的公开交锋。
摩根大通 CEO 戴蒙:支持对 AI 实施「轻度」联邦级监管、避免各州各自为政:此前并不热衷加强监管的戴蒙公开表态:各州法规不一将增加 AI 商业落地复杂性,如果一定要监管,应由联邦层面出台「轻度」模式。金融业开始为 AI 的合规成本结构与规则确定性下注。
查尔斯三世在苏格兰 AI 峰会警告「存在性危险」:呼吁以人类福祉约束技术:英国国王在苏格兰对 AI 行业领袖发表讲话,警告 AI 的「存在性危险」,呼吁把人类福祉置于技术竞赛之上;峰会聚集了黄仁勋、哈萨比斯与 OpenAI CFO 等高管。继峰会日程报道之后,讲话内容成为本周 AI 安全公共辩论的又一出场。
美国参议员 Booker 呼吁国会就 AI 召开特别会议:在 AI 安全立法窗口所剩不多、各州监管各自推进的背景下,这场参议院发言把「联邦层面是否以及如何行动」的争论再次推向台面。
Interpol:反恐行动借助 AI 识别 126 名嫌疑人:国际刑警组织披露一次多国反恐行动,借助人工智能分析识别出 126 名恐怖主义嫌疑人。这是执法机构把 AI 用进核心业务流程的最新公开案例——与「AI 用于网络攻击」的报道构成同一枚硬币的两面。
法庭记录:微软高管称 AI 训练是史上「最大的劳动力盗窃」:华盛顿邮报援引解封法庭记录报道:微软高层曾在一份内部材料中把 AI 训练称为「历史上最大的劳动力盗窃」;纽约时报同日报道微软与 OpenAI 员工对训练数据伦理的内部担忧。在「放缓 vs 加速」的宏观辩论之外,训练数据合法性正在成为诉讼与舆论的下一主战场。
法院驳回 OpenAI 调取苹果与马斯克公司和解文件的请求:与 OpenAI 针对 xAI 等关联诉讼的证据开示有关。前沿 AI 公司之间的诉讼战线继续拉长,信息披露的边界成为攻防焦点。
Al Jazeera 调查:ISIL 支持者利用 Grok 等 AI 绕过安全措施获取制造爆炸物信息:基于剑桥大学研究者的实地研究,ISIL 支持者在交流中公开分享绕过 AI 安全措施的方法,27 名受访者中约 10 人谈及 AI 与爆炸物。研究强调攻击者已把「越狱话术」当作常规工具——前沿实验室的滥用监测面临新的对手模型。
Hacker News 热帖:数学界为何有人拒绝签署菲尔兹奖得主联名信:围绕 25 位菲尔兹奖得主《AI 在数学中的严重错位》联名信,数学家 Timothy Gowers 发文解释自己为何没有签署:他认同对 AI 冲击数学研究生态的担忧,但认为联名信把「工具改变研究方式」与「学界失守」混为一谈。数学与 AI 的关系辩论仍在持续细化。
今日观察
这一天之后,三条线值得标记。
第一,「模型构建模型」进入公开计量阶段。Anthropic 给出 0 → 26% 的曲线,智谱在 10 万卡集群上让 GLM 建起承载自己的推理系统,Qwen 演示 12 小时优化小模型——三个案例的措辞都很克制(「尚未实现完全自主」「早期形态」),但它们共享同一个方向:研发效率本身开始被当成产品与指标来管理。接下来最有信息量的观察点不是能力分数,而是这三个「进度条」的更新频率与第三方可复核性。
第二,交付与定价第一次站到同一张桌上。OpenAI 用垂直索引换来 40% 的法律研究提升,Qwen 用 98% 的音频降幅把多模态推向「生产力」,GLM-5.3-FlashX 反向提价 2.5 倍,Nebius 年内第二次上调 GPU 租金——「更便宜」与「更贵」同时发生,说明市场在分层的不是模型,而是「延迟敏感 × 成本敏感」的需求结构。能把同一代智能拆成不同速度、不同价格的档位并维持利润率,正在成为模型商业化的核心手艺。
第三,安全的讨论正在从「要不要减速」下沉到「防线漏在哪」。Hacktron 用 Claude 打进 OpenAI 内网的链条里,没有一个环节是科幻:缺失的安全补丁、身份系统的配置缺陷、把 SSO 账号当枢纽的集成架构——全是传统安全的地基问题。同一周里,Al Jazeera 在报道 ISIL 支持者用商用 AI 获取爆炸物信息,英国国王在峰会上警告「存在性危险」,而微软的内部文件在法庭上被读出「最大的劳动力盗窃」。能力、责任与滥用正在被拆成一个个可审理、可披露、可整改的具体问题——这比「减速」的口号更接近真实的治理。
(完)